序言
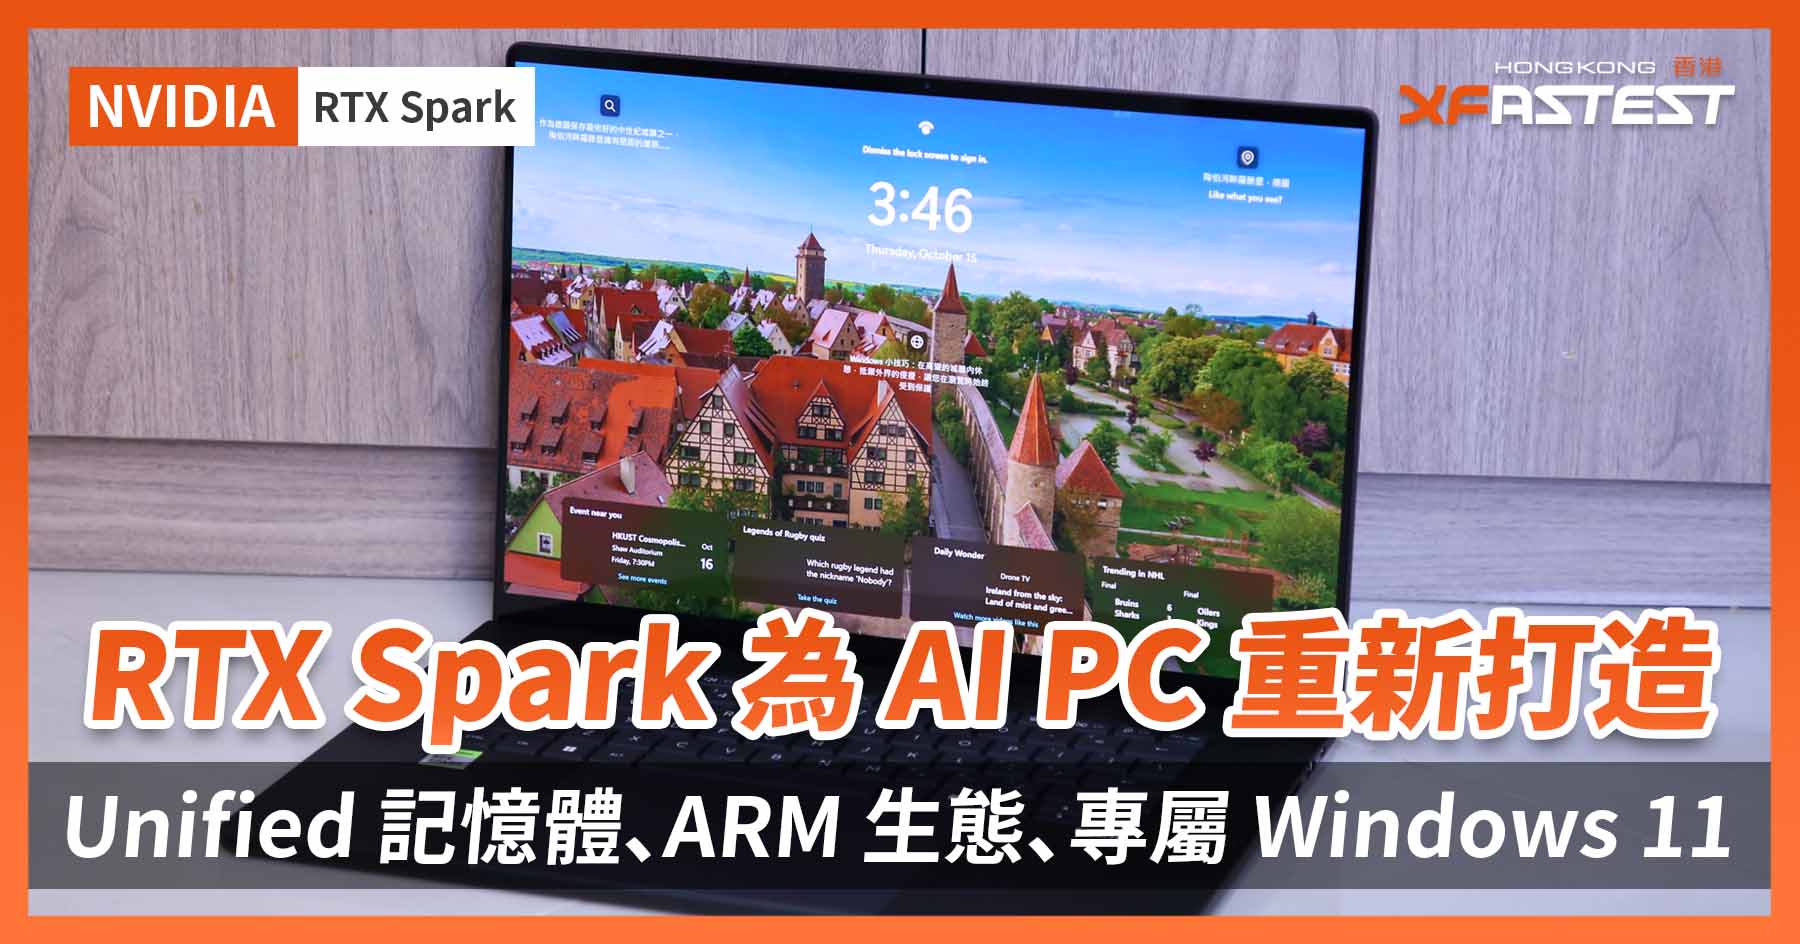
Microsoft 與 NVIDIA 聯手推出針對高階生成式 AI、創作、遊戲及自主代理程式,同時運行在一部輕薄 Windows 電腦上。NVIDIA RTX Spark 結合 Blackwell RTX GPU、Grace ARM CPU、最高 128GB Unified 記憶體與及完整 CUDA 生態。Microsoft 則從排程、記憶體、圖像介面、軟件兼容性及代理程式保安等環節重新改善 Windows 11。並不是把新處理器放進手提電腦,而是 Microsoft 與 NVIDIA 嘗試共同建立一種以本地 AI 為核心的全新 Windows PC。
Windows 為 RTX Spark 重新調校
RTX Spark N1X 的定位並非傳統意義上的獨立顯示卡,而是一套把 NVIDIA Blackwell RTX GPU、Grace ARM CPU、Unified 記憶體及 AI 軟件整合的超級芯片。當中最高階配置具備 6,144 個 Blackwell RTX CUDA 核心、20 個核心 Grace CPU、能提供最高 1 Petaflop FP4 AI 運算能力及 128GB LPDDR5X Unified 記憶體,同時可支援 Windows 11、DirectX 12 Ultimate、第五代 Tensor Core、第四代 RT Core、CUDA、DLSS 5 與 Reflex 2。NVIDIA 亦以 NVLink-C2C 互連 CPU 與 GPU,在維持較高能源效率的同時,減少不同處理單元交換資料時的樽頸。這種高度整合的 ARM 架構對 Windows 提出了新要求,RTX Spark 採用 Unified 記憶體,CPU 與 GPU 需要在同一記憶體資源池內處理不同工作。Microsoft 因此調整了 Windows 的工作排程、記憶體分配、功耗管理、圖像加速與 x86 軟件模擬機制,務求讓 AI、創作及遊戲工作都能充分使用硬件能力。


排程與功耗管理
在效能調校方面,Microsoft 為 RTX Spark 導入並優化 Workload Profile Scheduling(WPS)。這套機制讓 Windows 排程器按照工作負載特性,更有效地把不同任務分配至 Grace CPU,而不是單純依靠平均分配方式處理所有程式。 無論是一般日常使用還是在本機運行 AI 代理程式協助除錯,Windows 都可以因應負載類型與資源需求調整核心使用方式,從而平衡反應速度和能源效率。

Microsoft 同時與 NVIDIA 在 RTX Spark 上啟用 Microsoft Power and Thermal Framework。MPTF 的作用是協調系統效能、耗電與溫度,當 CPU、GPU 或 AI 工作突然提高負載時,系統可根據散熱能力與供電狀態作出相應調節。對輕薄型 RTX Spark 手提電腦而言,這一環尤其重要,因為高效能硬件能否長時間維持速度,往往取決於散熱、供電與排程設計,而不只是晶片的理論峰值。不過,WPS 與 MPTF 並不代表每款 RTX Spark 電腦都會有完全一致的效能和續航,不同廠商採用的散熱模組、機身厚度、電池容量及功耗設定仍會影響實際結果。
最高 128GB Unified 記憶體
RTX Spark 其中一個最吸引的設計就是可配置最高 128GB Unified 記憶體,有別於一般獨立顯示卡只能使用固定容量的 VRAM,RTX Spark 的 CPU 與 GPU 可以在 Unified 記憶體架構下存取同一資源,使大型語言模型、生成式 AI、影片剪輯及三維渲染工作不再受到傳統顯示記憶體容量的同等限制。

為了發揮這項硬件特性,Microsoft 提高並動態調整 Windows 允許 GPU 存取的系統記憶體上限。當系統配備較大容量記憶體時,GPU 可獲得更多空間載入本地 AI 模型、三維素材或高解像度創作專案,避免軟件因作業系統限制而無法充分利用。但這並不代表應用程式可以獨佔全部記憶體,Windows 系統、背景服務與其他正在執行的軟件仍需要保留一部分資源,可供個別工作使用的實際容量會因系統狀態而改變。Microsoft 亦改善 Unified 記憶體共享區域的分頁大小管理,較大的記憶體頁面有助減少大型工作負載的管理開支,適合處理龐大 AI 模型及複雜創作專案,同時開發者仍可根據 CPU 與 GPU 的資料存取模式調整記憶體使用方式。
DirectX 與神經網絡
圖像部分方面,Windows 為 Blackwell RTX GPU 提供 DirectX 12 神經網絡與光線追蹤最佳化基礎。RTX Spark 同時支援 DirectX 12 Ultimate、DLSS、Reflex 及硬件光線追蹤,讓系統除了執行生成式 AI,也能處理遊戲、三維創作與影片工作。所謂神經網絡,是利用 Tensor Core 協助重建影像、提升解像度、生成畫格或改善光線追蹤效果,讓 GPU 減少部分傳統渲染負擔,再以 AI 推論重建更完整畫面。
Windows ML 接通 TensorRT
在本地 AI 開發方面,Microsoft 與 NVIDIA把 Windows ML 連接至 TensorRT,讓開發者能在 Windows 應用程式內使用 RTX GPU 執行模型推論。TensorRT 負責針對 NVIDIA 硬件最佳化模型執行,而 Windows ML 則提供與 Windows 應用及工作流程整合的途徑,兩者結合可降低開發者調用 RTX Spark AI 運算能力的門檻。
RTX Spark 亦原生支援 CUDA,開發者可在同一部 Windows 電腦上建立、測試、微調及運行模型,再把相關工作部署到其他 NVIDIA GPU 平台。Microsoft 與 NVIDIA 計劃把 CUDA 加速的 PyTorch、llama.cpp、TensorRT、Hugging Face、Unsloth 及其他工具帶到 RTX Spark,藉此建立較完整的本地 AI 開發環境。
原生 ARM 與 Prism 支援
RTX Spark 使用 ARM 架構 Grace CPU,Microsoft 與 NVIDIA 已與軟件開發商合作擴展原生 Windows on ARM 生態,包括 Blender、DaVinci Resolve、Affinity、Adobe Photoshop 及 Premiere 等創作工具,另外還有 Cinema 4D、Redshift、CapCut、Cubase 與 Bitwig Studio 等程式提供原生 ARM 支援。 原生執行可減少模擬層帶來的額外負擔,但軟件能否使用 RTX GPU 加速,仍取決於是否支援 CUDA、TensorRT、OptiX 或其他 RTX 技術。
對於尚未推出 ARM 原生版本的傳統 x86 與 x64 軟件,Windows 則透過 Prism 模擬器維持兼容性。Prism 已針對 RTX Spark 微架構調校,並支援 32-bit 與 64-bit x86 應用,Microsoft亦持續改善其效能、兼容性及 AVX/AVX2 指令支援。能降低用戶轉用新平台的阻力,但始終模擬並不等同原生執行,個別舊程式、硬件驅動、插件或需要特殊指令集的軟件,仍可能出現效能或兼容性差異。

遊戲方面,RTX Spark 除了支援 DLSS、光線追蹤與 Reflex,Windows 生態亦正透過 Prism、Xbox PC 應用及反作弊系統支援擴大 ARM 遊戲陣容。Microsoft 已提到 Easy Anti-Cheat、BattlEye,以及《League of Legends》、《VALORANT》和《PUBG: Battlegrounds》等遊戲的支援計劃,不過 ARM 平台能否完整取代傳統 x86 遊戲電腦,仍需時間作出觀察。
為 AI Agent 建立界限
Windows 透過代理程式身分識別,把 Agent 的操作與使用者本人的操作分開記錄。代理程式可以使用本機識別資訊,或使用由 Microsoft Entra 支援的雲端身分,以分辨 Agent 執行了那些操作。新一代 Windows 安全機制將涵蓋身分、隔離、政策與端到端保安,讓本地 Agent 在使用者控制下執行。
Microsoft Execution Containers 則負責建立政策執行環境,開發者可以指定 Agent 能夠存取那些檔案、網絡資源與系統能力,再由 Windows 在執行期間強制實施界限。MXC 亦可按工作性質採用程序或工作階段等不同隔離方式。這套設計的重點,是避免 Agent 因錯誤指令、惡意內容或過度授權而接觸不應存取的資源,但實際可用功能仍會取決於 Windows 版本、SDK 及應用程式是否完成整合。
NVIDIA 亦會把 OpenShell 帶到 Windows,並與 Windows 的身分、保安及隔離能力配合。OpenShell可加入更細緻的代理程式政策,例如設定 Agent 可以與不可以進行的操作、按照私隱政策選擇本地或雲端模型,以及在資料傳送至雲端模型前屏蔽個人資訊。
ASUS ProArt P16 RTX Spark 手提電腦支援 4K 120Hz
今次收到的測試機為 ASUS ProArt P16 RTX Spark 手提電腦,採用全新的 ASUS Lumina Pro OLED 顯示技術,16 吋觸控螢幕採用適合專業創作的 16:10 比例,解像度達到 3840 × 2400,除了比一般 16:9 提供更大的垂直空間,也有利於顯示影片時間軸、圖層面板、程式碼及各種創作工具列。這款 OLED 面板具備 120Hz 更新率、可變更新率技術及 0.2ms 反應時間。相比傳統 60Hz 螢幕,120Hz 不只令 Windows 操作、網頁捲動及觸控反應更加流暢,在預覽高速影片、動畫與即時三維場景時,也能減少畫面殘影。它同時支援 NVIDIA G-SYNC,當 GPU 輸出幀率出現變化時,可以降低畫面撕裂與頓挫,兼顧內容創作和遊戲用途。

亮度與色彩表現同樣是 Lumina Pro OLED 的重要賣點,螢幕標示一般亮度為 700 nits,HDR 峰值亮度最高達 1,600 nits,覆蓋 100% DCI-P3 廣色域,並可顯示約 10.7 億種顏色。面板經過出廠校準,平均色差達到 Delta E 小於 1,亦獲得 Pantone Validated 認證,意味它不只是提供鮮艷討好的視覺效果,更瞄準影片調色、商業攝影、平面設計與數碼內容製作等重視顏色準確度的工作。針對傳統光面 OLED 螢幕雖然色彩鮮明,但在辦公室燈光、窗邊或戶外環境下容易產生倒影。Lumina Pro OLED 因此加入抗反射塗層,根據 ASUS 實驗室數據顯示可減少約 65% 光線反射,並提高環境光線下的畫面可讀性。 對經常在拍攝現場、會議室或交通工具上工作的創作者而言,抗反射處理有助減少使用者頻繁調高亮度來抵消反光的需要。螢幕同時支援觸控和手寫筆操作,適合直接進行構圖、遮罩調整、筆記或局部修圖。

16 吋機身輕薄化
ASUS ProArt P16 RTX Spark 手提電腦在機身設計上最薄位置約為 12.9mm,官方重量為約 1.77kg,亦是 ASUS 歷來最纖薄的 16 吋 ProArt 手提電腦,比上一代薄約 14%、輕約 9%。機身提供 Nano Black 與 Neo White 兩種選擇,其中 Nano Black 表面採用防污塗層,針對指紋、油脂與日常輕微刮痕提供額外抵抗力。機身的隱藏式轉軸除了令外形更簡潔,也兼負穩定結構與疏導散熱氣流的作用。 對經常攜帶電腦前往拍攝、剪輯或客戶會議的使用者而言,減少指紋殘留不只是外觀考慮,也可以降低日常清潔頻率。耐用度方面,ASUS ProArt P16 RTX Spark 手提電腦通過 MIL-STD-810H 標準,通過溫度、濕度、高度、震動、衝擊、沙塵及太陽輻射等測試。

連接能力照顧創作者
ASUS ProArt P16 RTX Spark 手提電腦的連接埠沒有因機身變薄而大幅縮減,機身提供三個 USB4 Type-C,最高支援 40Gbps 資料傳輸,並可用於影像輸出及電力傳輸在於使用者可以同時連接高速外置 SSD、專業顯示器、擷取裝置或供電設備。HDMI 2.1 FRL 則方便直接連接高解像度電視、投影機及外置螢幕,毋須另外攜帶轉接器。對攝影師與影片創作者而言,內置 SD Express 7.0 讀卡器更是關鍵設計,可以直接匯入相機素材,避免外置讀卡器佔用寶貴的 USB 連接埠。無線連接方面,產品配備三頻 2 × 2 Wi-Fi 7 及 Bluetooth 5.4,適合傳送大型專案、存取網絡儲存及連接無線周邊。儲存擴充方面,主機提供兩個 M.2 2280 PCIe 5.0 ×4 插槽,讓使用者日後增加SSD容量,或把系統與專案素材分開存放。ASUS 同時提醒,由於 M.2 插槽附近的主機板元件配置,裝置只支援單面 SSD,因此升級前必須確認 SSD 厚度與結構是否相容。


AI 應用及運算測試
大型語言模型雖然具備廣泛的知識與理解能力,但面對企業術語、專業文件及指定回答格式時,通用模型往往未必能直接符合實際需要。微調技術可以利用特定資料集,讓現有模型適應目標任務、專門詞彙與表達風格。然而,模型訓練通常需要大量 GPU 運算及記憶體,過去一般要依賴高階工作站或雲端服務。NVIDIA RTX Spark 結合 GPU 加速、大容量 GPU 可存取記憶體及 CUDA 軟件生態,把原本門檻較高的模型自訂工作帶到手提電腦上,讓開發者能夠在本機完成資料處理、LoRA 微調、測試與模型匯出。
Unsloth Studio
在這次示範中,訓練資料採用 NVIDIA FrameView User Guide,並被整理成問題與答案配對。微調目標是讓 Qwen3.5-9B 學習以簡短、直接和一致的方式回答與 FrameView 有關的技術問題。Qwen3.5-9B 是一款約 90 億參數的模型,官方模型檔案可用於 Hugging Face Transformers、vLLM、SGLang 等執行環境。這次示範的回答風格參考 ASD-STE100 Simplified Technical English,是一套受控英語寫作規範,重視簡單詞彙、主動語態、清晰句式及一個句子表達一項主要意思,目的在於減少技術內容。


可以看到當訓練完成後(右),無論是步驟還是用詞都變得更簡潔易明
Artificial Analysis AgentPerf
AgentPerf Local 最重要的一點是它屬於純效能基準,測試會量度系統處理錄製軌跡的速度,但不會檢查受測模型能否得出正確答案,也不會判斷它生成的程式碼是否修復了原有問題。即使某個系統以較短時間完成測試,也只能證明它在指定模型、量化格式、推理框架與設定下運行得較快,不能證明其 Agent 更聰明或任務成功率更高。

UL Procyon
UL 專業級基準工具 Procyon 將直接以三大高負載項目測試硬件效能,包括 SDXL 圖像生成、四款主流大型語言模型,以及涵蓋辨識、偵測與分割的電腦視覺測試,以測試其性能。


MLPerf Client
MLPerf Client 利用新加入 FLUX.2 Klein 4B 圖像生成及代理式 AI 測試,不再只看單次推論速度。代理測試模擬軟件工程與數據分析流程,穿插多輪 LLM 推論及工具調用,能夠直接測試整部電腦的協同效能。


內容創作測試
Blender 5.3 引入 DLSS 4.5 光線重建,取代傳統降噪流程,讓 Cycles 路徑追蹤視窗在移動鏡頭、調校材質及燈光時,仍能即時呈現接近成品的畫質。這項延續 OptiX 整合成果的新功能,解決多年困擾 3D 創作者的等待時間,讓「邊改邊看」真正走向實用。


工作流測試
不少人使用 AI 的其中一個原因,就是能夠令原本不少重複性的工作或流程變得自動化或簡單化,Comfy Desktop 透過內建的 Performance Tests 功能,進行測量工作流在不同實例上的執行速度。當中會分別測試圖像和影片,透過採用不同的模型與及比較在 FP8 和 NVFP4 下的效能表現。


遊戲測試
雖然正常來說,選擇 RTX Spark 平台都不會主要是用來玩遊戲,但用家還是可以在空間時用來玩遊戲。加上當中亦可支援與獨立顯示卡的相同技術,因此整體來說都能滿足現時遊戲的要求。
3DMark


總結
從技術方向來看,Windows on ARM 在 RTX Spark 最值得注意之處,是 Microsoft 與 NVIDIA 沒有把它當成普通 ARM 電腦或單純的 AI 加速器處理。WPS 與 MPTF 負責效能、耗電與溫度協調,統一記憶體最佳化讓 GPU 有機會使用更大資源池,DirectX、Windows ML、TensorRT 及 CUDA 則分別服務遊戲、創作與 AI 開發,原生 ARM 應用和 Prism 則共同處理軟件相容性。再加上 Agent Identity、MXC 及 OpenShell,平台由底層硬件一直延伸至代理程式的權限與保安管理。對 AI 開發者和專業創作者而言,最高 128GB Unified 記憶體可能比單純提高 CPU 跑分更具吸引力,因為它可容納傳統手提電腦 GPU 難以載入的大型模型與創作資料。 對一般玩家來說,真正考驗則是 ARM 遊戲兼容性、Prism 模擬效能、持續功耗。對企業與進階用戶而言,MXC 與 Agent Identity 的重要性甚至可能高於峰值 AI 算力,因為只有在權限可控、操作可追查、資料界限清晰的情況下,自主 Agent 才適合接觸真實工作檔案。